 Par Adri
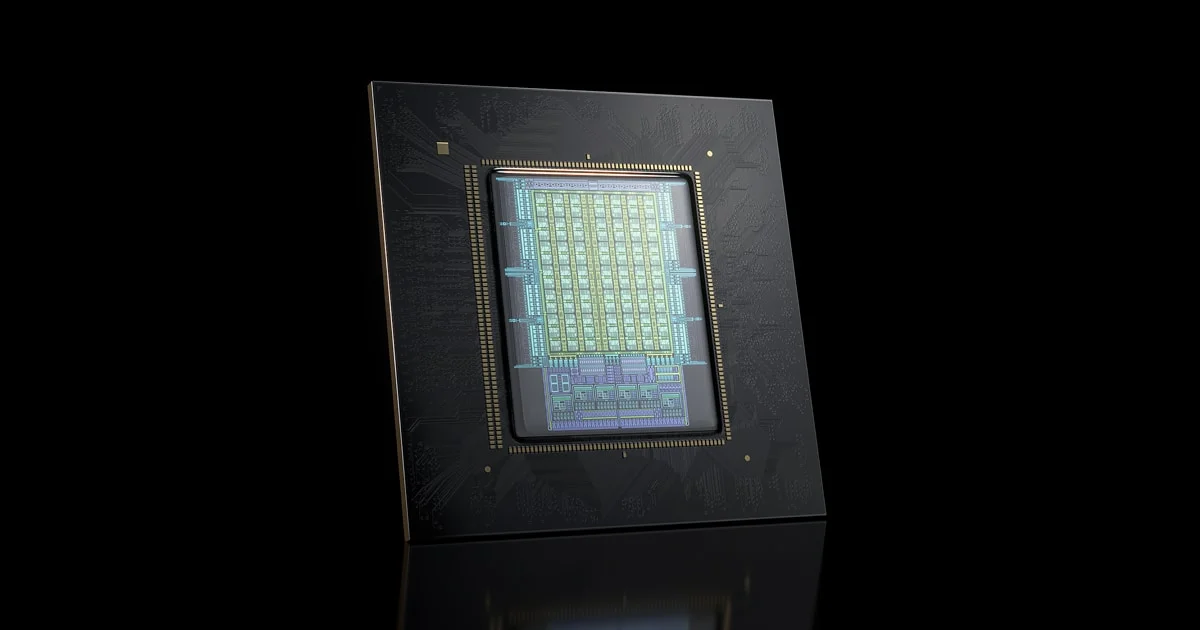
Le processeur central n'avait pas disparu des infrastructures IA. Il était simplement devenu moins visible que les GPU chargés d'entraîner et d'exécuter les grands modèles de langage. Avec la multiplication des agents capables de manipuler des fichiers, compiler des programmes et exécuter des outils, les tâches confiées au CPU reviennent au premier plan.
Modal vient d'en donner une illustration assez précise. Le fournisseur américain d'infrastructure cloud a reçu un premier serveur NVIDIA Vera dans ses locaux de San Francisco, puis publié les résultats de plusieurs benchmarks consacrés aux environnements Sandboxes.
Le constat mis en avant par l'entreprise est spectaculaire : jusqu'à deux fois plus de tâches terminées par unité de temps qu'avec une machine x86 Intel Granite Rapids comparable, lorsque le nombre d'exécutions simultanées augmente fortement.
Ce résultat provient des propres mesures de Modal, publiées le 19 octobre. Il n'a pas été validé indépendamment dans les mêmes conditions et ne signifie pas que Vera est deux fois plus rapide que tous les processeurs Intel et AMD. Les essais mettent en évidence un comportement particulier : la capacité à conserver un débit élevé lorsque de nombreux environnements isolés sollicitent le serveur.
Ce que Modal a réellement mesuré
Pour son benchmark, Modal a constitué Agentless Agent Bench, une collection de 50 tâches issues de Terminal-Bench. Les exercices concernent notamment la compilation de logiciels, les recherches dans des fichiers, certaines opérations Git et l'émulation de périphériques.
Les appels réseau ont été supprimés et les conteneurs Docker ont été préinitialisés. L'objectif était d'isoler le travail effectué par le processeur au lieu de mesurer des attentes provoquées par des services externes ou des téléchargements.
Deux catégories de mesures ont ensuite été distinguées. La première concerne la latence : combien de temps faut-il pour terminer une tâche exécutée seule, sur une machine peu sollicitée ? La seconde examine le débit obtenu lorsque plusieurs conteneurs travaillent simultanément.
Sur les tâches exécutées individuellement, Vera termine souvent avant les processeurs concurrents. Pas toujours, et les écarts restent parfois modestes. Modal a confronté son serveur à plusieurs architectures, dont Intel Granite Rapids, AMD Zen 5 et les processeurs AWS Graviton.
Le classement change avec la concurrence entre tâches. Lorsque le nombre de conteneurs augmente, les plateformes concurrentes atteignent progressivement un plafond de débit. Vera conserve une progression plus favorable et peut terminer jusqu'à deux fois plus de tâches dans certaines configurations testées.
Modal indique également que cette hausse de débit ne s'accompagne pas nécessairement d'une dégradation du temps de réponse individuel. Dans les essais décrits, certaines latences restent comparables, voire inférieures, à celles de la machine x86 de référence.
C'est le point le plus intéressant du benchmark. Le bénéfice ne réside pas principalement dans un programme exécuté deux fois plus vite, mais dans la quantité de travaux pouvant cohabiter sur une même machine.
Pourquoi les agents IA mettent les CPU sous pression
Un agent de programmation alterne généralement entre plusieurs types d'opérations. Il sollicite un modèle de langage, attend une réponse, lit des fichiers, lance une commande, exécute un test, puis transmet les résultats au modèle avant de recommencer.
Une grande partie de ces opérations ne nécessite pas directement de GPU. Les tâches de compilation, les processus système et l'exécution de scripts reposent sur les ressources classiques du serveur.
Modal explique que ses Sandboxes accueillent des centaines de conteneurs ou de machines virtuelles sur un même hôte. Les profils de consommation peuvent être très irréguliers : un environnement reste presque inactif pendant qu'il attend un modèle, puis multiplie momentanément sa demande en CPU lorsqu'un agent lance une installation de dépendances ou une commande coûteuse.
Ces pics peuvent atteindre dix fois la consommation habituelle observée pour certaines tâches, selon les exemples communiqués par l'entreprise.
Lorsque les ressources sont partagées, un problème classique apparaît : un environnement très actif peut ralentir les autres. C'est le phénomène de contention entre utilisateurs, parfois appelé noisy neighbor.
Modal cherche à densifier ses serveurs sans dégrader excessivement les performances des applications hébergées. Une meilleure résistance à la contention permettrait de faire fonctionner davantage d'environnements par machine tout en conservant une certaine stabilité de latence.
Les usages d'apprentissage par renforcement constituent un autre cas important. Lorsqu'une série d'agents doit effectuer des évaluations avant une nouvelle étape d'entraînement, les GPU peuvent attendre la fin des opérations exécutées sur CPU. Réduire ces délais peut améliorer l'utilisation globale de l'infrastructure.
88 cœurs Olympus et une bande passante mémoire particulièrement élevée
L'architecture Vera repose sur 88 cœurs Olympus développés par NVIDIA, compatibles avec le jeu d'instructions Arm. Chaque cœur peut gérer deux threads grâce à une technologie de multithreading conçue pour soutenir les performances lorsque le processeur est fortement sollicité.
NVIDIA a conçu ces cœurs pour des tâches marquées par des branchements fréquents, des accès mémoire irréguliers et de nombreuses opérations successives. Le constructeur décrit notamment un frontal de décodage capable de traiter jusqu'à dix instructions par cycle, un prédicteur de branchement neuronal et une exécution dynamique avancée.
La conception du processeur rassemble les 88 cœurs dans une structure monolithique avec un système de cache partagé. Cette organisation vise à limiter certaines pénalités de communication entre groupes de cœurs et à maintenir des performances prévisibles lorsque de nombreux processus travaillent simultanément.
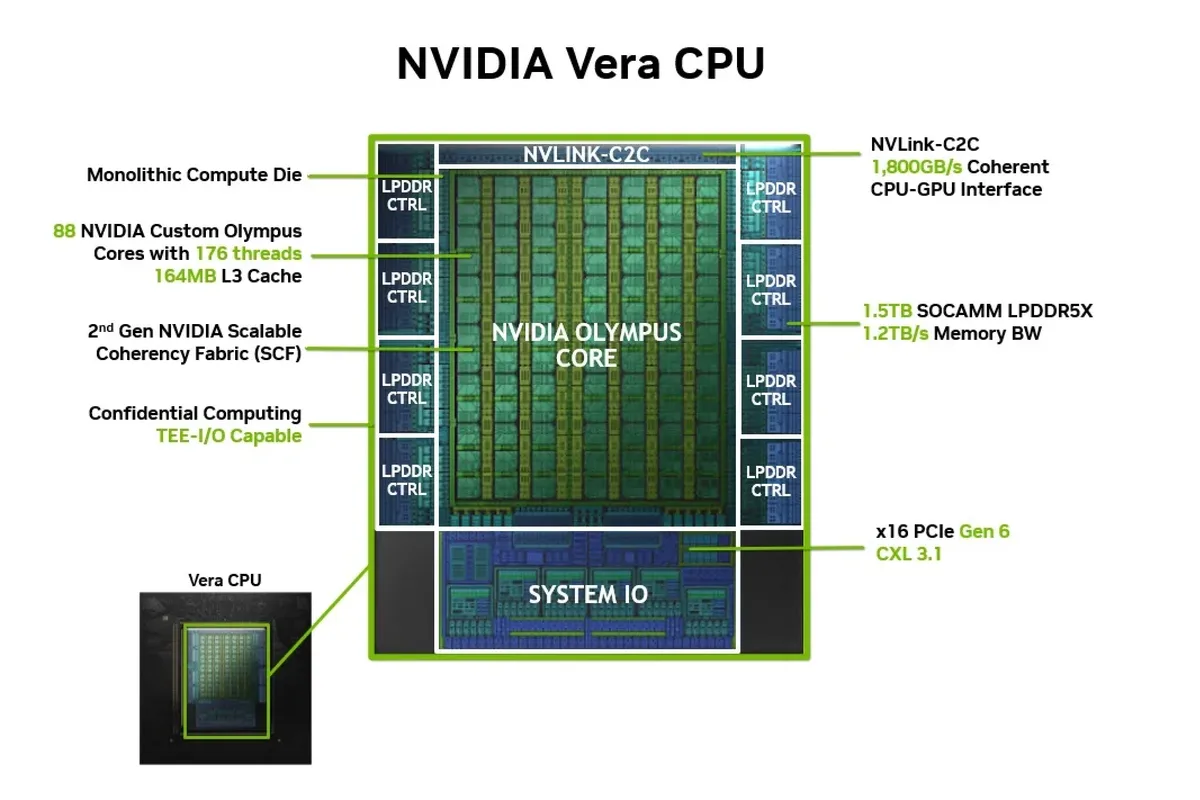
La mémoire joue un rôle central. NVIDIA annonce jusqu'à 1,2 To/s de bande passante avec de la LPDDR5X et une capacité pouvant atteindre 1,5 To selon la configuration. Le constructeur met particulièrement en avant la bande passante disponible par cœur.
Modal attribue une grande partie de ses résultats à cette capacité de déplacement des données. Plusieurs environnements isolés peuvent accéder à leurs propres fichiers, bibliothèques et structures mémoire sans saturer aussi rapidement les ressources partagées.
Ces explications correspondent aux caractéristiques présentées par NVIDIA et aux observations de Modal. Elles ne démontrent pas à elles seules quelle proportion exacte du gain mesuré provient de la mémoire, de l'architecture des cœurs ou d'autres éléments du système.
Le passage d'Intel et AMD à Arm ne se fera pas sans travail
Modal a historiquement construit ses infrastructures Sandboxes autour de processeurs x86. L'arrivée de Vera signifie qu'une partie de ses serveurs utilisera désormais une architecture différente.
Pour les applications qui exécutent essentiellement du code Python, JavaScript ou des logiciels disponibles sur plusieurs architectures, la migration peut être relativement simple. Les difficultés apparaissent davantage lorsque les environnements utilisent des binaires natifs, des dépendances compilées ou des images contenant du logiciel prévu exclusivement pour x86.
Modal indique qu'elle devra adapter son infrastructure et son système de construction d'images pour prendre en charge Arm. Cette transition est donc un chantier technique, et pas seulement un remplacement matériel.
L'entreprise n'annonce pas l'abandon de ses fournisseurs actuels. Son directeur général, Erik Bernhardsson, a expliqué à Reuters qu'Intel et AMD continueraient à faire partie de son infrastructure, les processeurs étant sélectionnés en fonction des charges de travail.
Le calendrier de disponibilité des Sandboxes exécutées sur Vera n'a pas encore été communiqué. Modal présente une intention de déploiement et des essais initiaux, pas une migration déjà achevée de l'ensemble de ses serveurs.
Pour NVIDIA, le CPU devient aussi stratégique que le GPU
NVIDIA avait déjà présenté Vera comme un processeur destiné aux infrastructures d'intelligence artificielle, avec des déploiements autonomes et une intégration à ses plateformes Vera Rubin.
Le constructeur vise notamment les tâches intermédiaires qui accompagnent l'exécution des modèles : orchestration, traitement des données, opérations sur les fichiers, simulations et coordination des environnements de calcul.
Cette approche répond à une évolution des usages. Un assistant qui génère simplement une réponse ne mobilise pas les mêmes ressources qu'un agent travaillant pendant plusieurs minutes à travers une succession d'outils et de commandes.
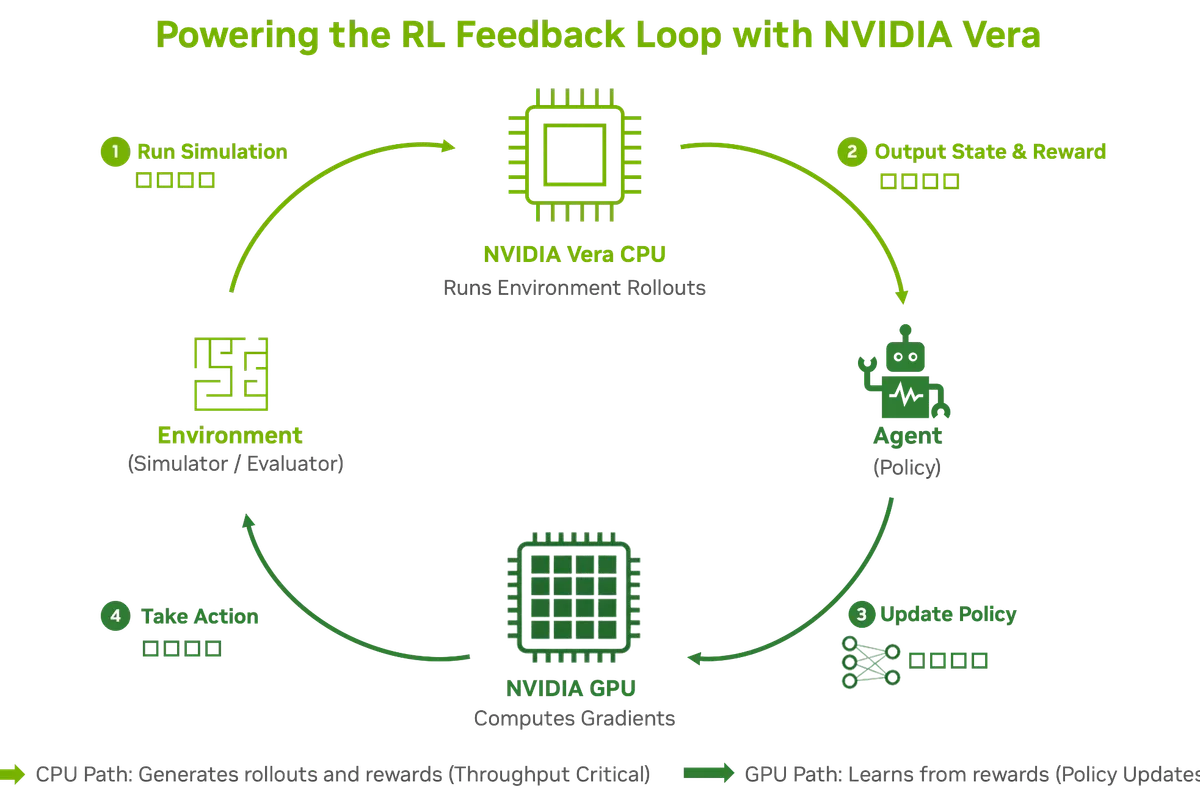
Un CPU plus rapide peut également améliorer indirectement l'exploitation des GPU. Lorsque les opérations entre deux passages du modèle prennent moins de temps, les systèmes peuvent réduire certaines attentes et mieux utiliser les accélérateurs déjà installés.
NVIDIA cherche ainsi à étendre son influence au-delà des puces graphiques. L'entreprise propose désormais une architecture englobant le calcul généraliste, les GPU, les réseaux, les logiciels et les mécanismes de communication entre composants.
Cette extension la place plus directement face à Intel et AMD sur un marché dont les configurations matérielles étaient traditionnellement dominées par leurs processeurs x86. Elle rejoint également la concurrence des solutions Arm proposées par les fournisseurs cloud.
Reuters rapporte que NVIDIA vise au moins 20 milliards de dollars de revenus avec Vera pendant son exercice fiscal en cours, dans un marché des CPU pour centres de données que le groupe estime à environ 200 milliards de dollars. Ces montants correspondent à des objectifs et estimations rapportés, pas à des ventes déjà réalisées.
Le coût réel par tâche reste à démontrer
Pour Modal, le débit brut constitue une métrique importante, mais il ne suffit pas à déterminer la rentabilité finale d'une plateforme.
Une machine capable d'exécuter deux fois plus de tâches peut être plus intéressante si son prix d'achat, sa consommation électrique et ses coûts de maintenance restent compatibles avec ce gain. Sans données comparables sur le coût total des serveurs, il serait prématuré d'annoncer une division par deux du coût des Sandboxes.
Les conditions du benchmark limitent également sa généralisation. Les tâches ont été sélectionnées pour représenter certains usages d'agents, les appels réseau ont été retirés et les environnements ont été préinitialisés. Les applications réelles peuvent rencontrer d'autres contraintes : accès au stockage distant, temps d'attente des modèles, mémoire disponible, réseau ou logiciel incompatible avec Arm.
L'intérêt de l'annonce reste substantiel. Un fournisseur cloud qui utilisait exclusivement Intel et AMD envisage désormais une troisième architecture parce qu'elle répond mieux à certaines contraintes de son infrastructure.
Modal n'a pas communiqué de date de disponibilité générale pour les environnements Vera. Les prochains éléments déterminants seront les performances sur les applications de production, les coûts par tâche exécutée et la proportion de charges pouvant réellement migrer vers Arm.