 Par Adri
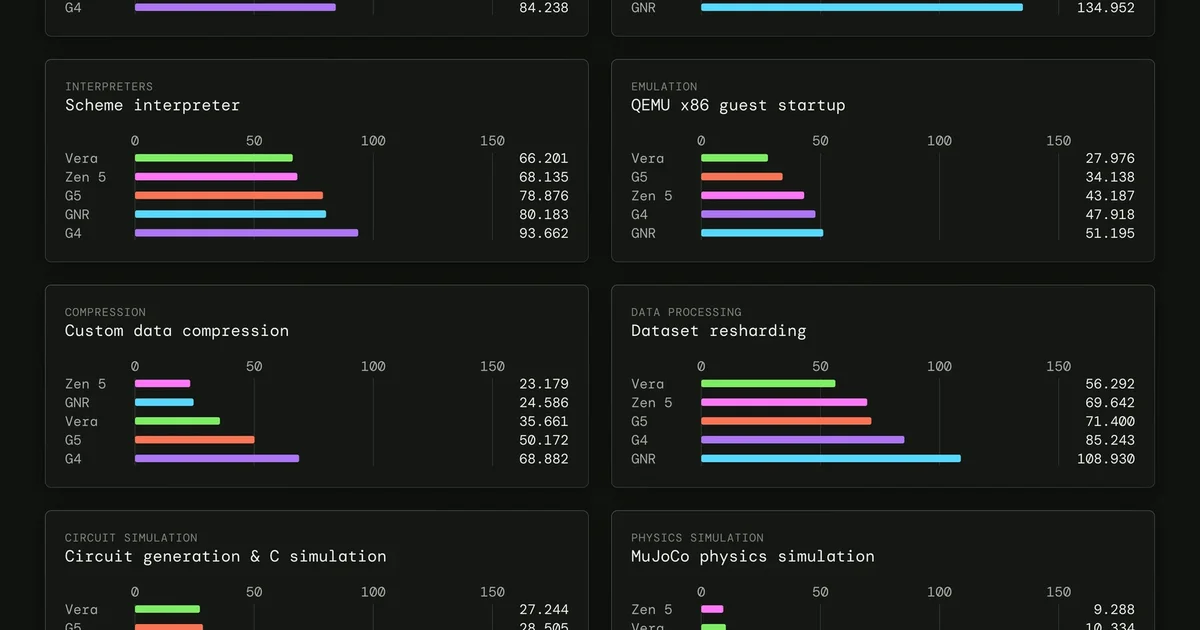
Quand une intelligence artificielle rédige une réponse, l'attention se porte généralement sur le modèle de langage et sur les GPU qui assurent ses calculs. Mais un agent chargé de programmer une application ne passe pas son temps à générer des tokens. Il installe des dépendances, parcourt des fichiers, lance des commandes et exécute des tests. Ces opérations reposent largement sur le processeur central. Et lorsque des milliers d'agents travaillent en parallèle, les CPU deviennent une ressource stratégique. C'est précisément ce que vient de mettre en évidence Modal. Le fournisseur américain d'infrastructures cloud a publié le 19 octobre une évaluation de NVIDIA Vera, le processeur Arm développé pour les centres de données et les charges d'intelligence artificielle. Les résultats ont suffisamment convaincu Modal pour qu'il annonce son intention d'intégrer cette architecture à son offre Sandboxes. Il s'agira d'un changement important. Jusqu'ici, les environnements d'exécution de l'entreprise fonctionnaient sur des processeurs x86 Intel et AMD. L'arrivée de Vera ouvrira la porte à une troisième famille de matériel, mais aussi à un nouvel ensemble de contraintes logicielles. Le gain annoncé est spectaculaire dans certains scénarios. Encore faut-il comprendre ce que Modal a réellement mesuré.
Un processeur NVIDIA à la place d'Intel ou d'AMD
NVIDIA est surtout connu pour ses accélérateurs graphiques, devenus essentiels à l'entraînement et à l'inférence des modèles d'IA. Pourtant, son ambition dans les centres de données ne se limite plus aux GPU. Vera est un processeur central reposant sur l'architecture Arm, avec des cœurs conçus par NVIDIA. Il peut accompagner les GPU Rubin dans des systèmes complets, mais aussi fonctionner dans des serveurs autonomes. Ce deuxième usage intéresse particulièrement Modal. Les agents hébergés par l'entreprise ont besoin d'environnements Linux capables d'exécuter du code et des outils logiciels. Ces opérations ne justifient pas toutes l'utilisation d'un GPU. Elles exigent en revanche des ressources CPU rapides, de la mémoire et une bonne gestion de milliers de processus. Modal utilisait historiquement des serveurs équipés de processeurs Intel et AMD. Selon Reuters, le directeur général Erik Bernhardsson souhaite désormais élargir cette infrastructure à Vera. Il ne prévoit pas pour autant d'abandonner les fournisseurs existants. L'idée est de disposer de plusieurs architectures et d'orienter les charges vers celles qui offrent le meilleur résultat. La stratégie est pragmatique : un bon processeur pour un type de tâche n'est pas nécessairement le meilleur pour toutes les autres.
Pourquoi les Sandboxes sont si difficiles à optimiser
Modal Sandboxes fournit des environnements isolés permettant aux agents d'exécuter des commandes et du code. Chaque Sandbox fonctionne comme un espace dans lequel une tâche peut être réalisée sans disposer automatiquement d'un accès complet aux autres environnements. Ce fonctionnement est utile pour les agents de programmation. L'un peut compiler une application pendant qu'un autre analyse des fichiers ou prépare des tests. Mais les ressources nécessaires changent constamment. Un environnement peut rester presque inactif pendant qu'il attend la réponse d'un modèle de langage. Quelques secondes plus tard, il peut lancer une installation de dépendances qui provoque un pic de charge. Modal cite des opérations comme npm install ou des recherches intensives avec grep. Dans certains exemples, la consommation CPU peut momentanément atteindre dix fois le niveau habituel. La difficulté augmente lorsque plusieurs centaines de conteneurs et de machines virtuelles partagent un même serveur. Les besoins de chacun sont différents. Le fournisseur cloud ne peut donc pas connaître à l'avance le comportement exact de tous les agents. Cette imprévisibilité constitue l'une des raisons pour lesquelles Modal cherche des processeurs capables de conserver de bonnes performances lorsque la concurrence entre tâches devient forte.
Le problème du voisin bruyant
Dans les infrastructures mutualisées, un utilisateur peut parfois ralentir les autres sans même le savoir. Les ingénieurs appellent ce phénomène le noisy neighbor, ou voisin bruyant. Imaginons un serveur hébergeant de nombreux agents. La plupart attendent des résultats et utilisent peu de ressources. Soudain, plusieurs agents décident de compiler du code. Ils sollicitent les cœurs CPU, la mémoire et les caches. Les autres environnements peuvent alors subir des ralentissements. Le problème ne concerne pas nécessairement la puissance maximale du processeur. Il dépend de sa capacité à répartir efficacement les ressources entre de nombreuses demandes simultanées. Modal utilise déjà un mécanisme de bursting permettant à ses clients de réserver une capacité adaptée à leur consommation habituelle. Les pointes temporaires peuvent utiliser des ressources supplémentaires disponibles sur le serveur. Ce système évite de payer en permanence pour le pire scénario. Mais il rend également la plateforme sensible aux pics simultanés. Un processeur qui supporte mieux cette concurrence pourrait donc améliorer à la fois les performances des utilisateurs et l'efficacité économique de l'hébergement.
Jusqu'à deux fois plus de tâches terminées sous forte charge
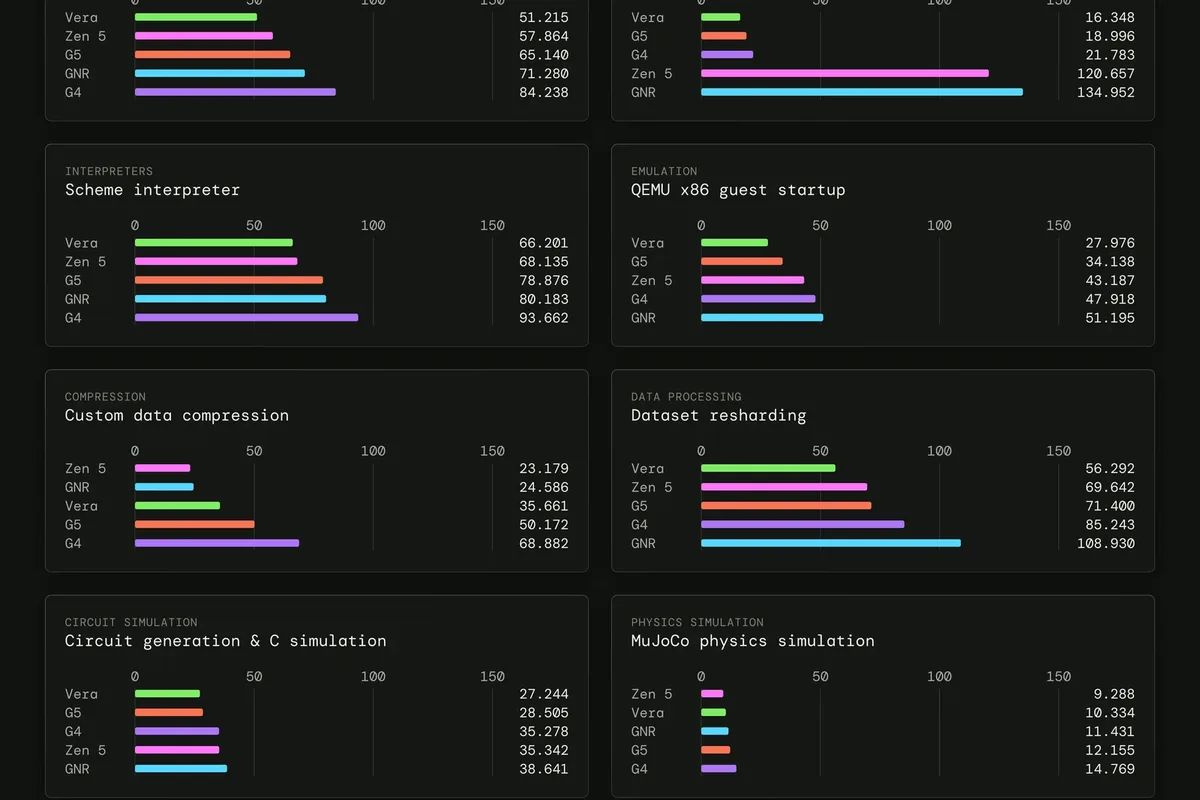
Pour évaluer Vera, Modal a développé son propre ensemble de tests. Il s'appelle Agentless Agent Bench. Le nom peut sembler paradoxal. L'objectif est précisément d'évaluer le travail CPU normalement accompli par des agents, sans inclure tous les délais associés aux appels des modèles ou aux communications réseau. Le protocole rassemble cinquante tâches et vérificateurs issus de Terminal-Bench. Il comprend notamment de la compilation, des opérations Git, des recherches dans les fichiers et des travaux d'émulation. Les tâches sont exécutées dans des conteneurs Docker préalablement préparés. Modal augmente ensuite le nombre d'environnements concurrents et mesure la quantité de travail terminée pendant une durée donnée. C'est dans ces conditions que Vera se distingue. L'entreprise rapporte jusqu'à deux fois plus de tâches terminées qu'avec un serveur Intel Granite Rapids x86 comparable. Elle affirme également que la latence individuelle reste similaire, voire inférieure dans certains scénarios. Ce résultat est intéressant parce que le débit global et la réactivité individuelle entrent souvent en concurrence. Lorsqu'on ajoute des tâches à un serveur, on augmente généralement le nombre total d'opérations réalisées, mais on risque de ralentir chacune d'elles. Modal affirme que Vera parvient à repousser ce compromis. Il s'agit toutefois de tests internes, réalisés par une entreprise qui prévoit d'utiliser le matériel.
Deux fois plus de débit ne signifie pas deux fois plus de vitesse
La distinction est capitale pour interpréter l'annonce. Le débit mesure la quantité de travail terminée pendant une période. La latence mesure le temps nécessaire à une tâche individuelle. Un serveur capable de réaliser deux cents opérations pendant qu'un autre en termine cent présente un débit deux fois supérieur. Cela ne signifie pas que chaque opération individuelle est exécutée en deux fois moins de temps. Les premiers essais de Modal le montrent d'ailleurs très clairement. Lorsque les tâches sont lancées de manière séquentielle sur une machine peu chargée, Vera obtient souvent de bons résultats. Mais il n'est pas systématiquement le plus rapide. L'auteur du rapport, Erik Dunteman, indique même avoir été initialement peu convaincu par les écarts observés. La différence apparaît surtout lorsque la concurrence augmente. Les autres processeurs commencent alors à atteindre des plafonds de débit, tandis que Vera continuerait à absorber davantage de tâches. Le titre du rapport de Modal évoque donc un doublement du débit des Sandboxes. Ce n'est pas une promesse selon laquelle tous les agents d'intelligence artificielle termineraient leurs missions en moitié moins de temps.
Pourquoi Vera résisterait mieux à la saturation
Modal met en avant la bande passante mémoire de Vera pour expliquer ses résultats. Un processeur ne peut pas travailler efficacement si ses cœurs attendent constamment les données dont ils ont besoin. Lorsque de nombreux processus fonctionnent simultanément, les accès à la mémoire deviennent un facteur important. NVIDIA a conçu Vera avec 88 cœurs Olympus personnalisés et 176 threads matériels. Le processeur bénéficie également d'un sous-système mémoire LPDDR5X capable d'atteindre, selon le constructeur, une bande passante agrégée de 1,2 To/s. L'architecture comprend des mécanismes de cohérence et de gestion des caches destinés aux charges de travail fortement concurrentes. Ces caractéristiques sont particulièrement pertinentes pour des serveurs exécutant de nombreuses Sandboxes. Chaque environnement utilise ses propres processus et manipule des données différentes. Une architecture capable de limiter les attentes mémoire peut améliorer l'utilisation des cœurs. Modal estime que Vera permet de faire fonctionner davantage de conteneurs par cœur sans provoquer les ralentissements constatés sur certaines machines concurrentes. Cette explication est cohérente avec la conception du processeur. Mais l'importance exacte de chaque composant dans les résultats observés n'a pas été isolée par un audit indépendant.
NVIDIA ne veut plus laisser le marché des CPU serveurs à ses concurrents
Le choix de Modal possède aussi une dimension industrielle. Pendant des années, NVIDIA a surtout vendu les accélérateurs qui accompagnaient les processeurs des autres fabricants. Le marché des serveurs généralistes restait dominé par Intel et AMD, avec une concurrence Arm croissante. Vera représente une offensive plus directe. NVIDIA peut désormais proposer ses propres processeurs pour les tâches qui entourent les modèles d'IA. Cela concerne l'orchestration, la préparation des données, l'exécution des outils et certaines opérations d'apprentissage. Reuters rapporte que NVIDIA vise au moins 20 milliards de dollars de ventes de processeurs Vera sur son exercice fiscal en cours. Le groupe présente le marché potentiel des CPU pour centres de données comme une opportunité considérable. Ces ambitions financières ne doivent pas être confondues avec des ventes déjà réalisées. Mais elles montrent que Vera constitue davantage qu'un composant complémentaire de Rubin. NVIDIA cherche à gagner une place centrale dans l'infrastructure utilisée pour faire fonctionner les agents. Le contrat annoncé avec Modal représente ainsi un signal commercial important. Il montre qu'un fournisseur historiquement organisé autour de serveurs x86 juge désormais intéressant d'adapter son infrastructure à Arm.
Passer de x86 à Arm impose des changements logiciels
Les gains matériels ne peuvent pas être exploités sans travail d'intégration. Modal explique que l'arrivée d'Arm représente une évolution importante pour ses équipes. Ses systèmes étaient historiquement conçus autour de processeurs x86. Or un programme compilé pour x86 ne fonctionne pas nécessairement de manière native sur un processeur Arm. Cela concerne certains exécutables, bibliothèques et dépendances. Le fournisseur doit donc adapter son infrastructure et son système de construction d'images logicielles. Les développeurs utilisant Modal peuvent également dépendre de composants dont les versions Arm ne sont pas disponibles ou suffisamment testées. Dans certains cas, une recompilation peut suffire. Dans d'autres, il faudra adapter ou remplacer des outils. Cette transition explique pourquoi Modal ne prévoit pas de supprimer ses machines Intel et AMD. Une infrastructure mixte permet de conserver la compatibilité des charges anciennes tout en proposant les avantages de Vera pour les applications adaptées. Le choix du processeur pourra alors devenir une décision d'ordonnancement. Chaque type de travail serait orienté vers le matériel qui le réalise le mieux. Cette souplesse a une valeur importante dans un marché où les besoins des agents évoluent rapidement.
La vitesse du CPU peut aussi réduire les attentes des GPU
Le bénéfice potentiel ne concerne pas uniquement les Sandboxes utilisées par les assistants de programmation. Modal héberge également des opérations liées à l'apprentissage par renforcement. Dans certains systèmes, un modèle doit produire plusieurs actions qui sont ensuite exécutées et évaluées dans des environnements séparés. Les GPU réalisent une partie des calculs du modèle. Les CPU prennent en charge l'exécution des programmes et les vérifications nécessaires. Lorsque les évaluations sont synchronisées, il peut arriver que des GPU restent inutilisés en attendant la fin du travail CPU. Cette attente a un coût. Les accélérateurs graphiques sont chers, et leur efficacité dépend du temps pendant lequel ils effectuent réellement des calculs utiles. Accélérer les étapes exécutées sur CPU peut donc améliorer l'utilisation de l'ensemble de l'infrastructure. Un processeur serveur plus performant sous forte concurrence pourrait produire un bénéfice économique supérieur à la seule réduction de son temps de calcul. Mais ces avantages doivent être mesurés sur des pipelines complets. Les tests Agentless Agent Bench isolent volontairement certaines opérations CPU. Ils ne démontrent pas à eux seuls une réduction universelle des dépenses d'entraînement.
Modal ne tourne pas le dos à Intel et AMD
Malgré l'enthousiasme suscité par Vera, le discours de Modal reste mesuré. Erik Bernhardsson a expliqué à Reuters que l'entreprise conserverait une stratégie fondée sur plusieurs architectures. Les serveurs Intel et AMD resteront utilisés. Les processeurs NVIDIA seront ajoutés lorsque leurs performances justifieront leur adoption. Le dirigeant rappelle également que les concurrents de NVIDIA préparent de nouvelles générations de puces. Les comparaisons publiées concernent donc des processeurs existants au moment des essais. Elles ne permettent pas de prédire les résultats face à des modèles futurs qui n'ont pas encore été évalués. Cette approche est importante pour les clients. Une infrastructure cloud doit rechercher des performances fiables sur des années, pas seulement remporter un benchmark au moment d'une annonce. Les prix des serveurs, leur consommation, leur disponibilité et leur compatibilité logicielle peuvent aussi modifier l'équation. Le processeur qui offre le meilleur débit dans un test ne présente pas nécessairement le coût total le plus faible pour tous les workloads. Modal devra donc équilibrer puissance, dépenses et simplicité d'exploitation.
Un déploiement annoncé, pas encore une disponibilité générale
NVIDIA a livré un premier serveur Vera à Modal dans ses bureaux de San Francisco pendant la semaine précédant l'annonce. Le matériel a permis de réaliser les premiers tests. Modal indique désormais vouloir travailler avec NVIDIA et ses partenaires cloud pour étendre la prise en charge du processeur. Cette étape est réelle. Mais la publication du 19 octobre ne fournit pas de calendrier ferme pour une ouverture générale des Sandboxes Vera aux clients. Il ne faut donc pas présenter chaque environnement Modal comme déjà hébergé sur des processeurs NVIDIA. L'entreprise devra d'abord finaliser les adaptations nécessaires et organiser son approvisionnement. Elle devra également vérifier la stabilité du service sous des charges réelles. Une application utilisée en production présente davantage de contraintes qu'un benchmark conçu pour isoler une caractéristique précise. La validation nécessitera des mesures de performances, de disponibilité et de consommation sur une période suffisamment longue. C'est à ce stade que l'intérêt économique de Vera pourra être confirmé pour les clients.
Une nouvelle bataille pour l'infrastructure de l'IA
L'annonce de Modal intervient alors que les fournisseurs d'infrastructures dédiées à l'intelligence artificielle connaissent une croissance rapide. Reuters indique que l'entreprise a récemment levé 750 millions de dollars lors d'une opération menée par Accel, sur la base d'une valorisation de 15,75 milliards de dollars. Modal se présente comme un fournisseur capable d'héberger des modèles et d'exécuter les outils nécessaires aux applications d'IA. Cette double fonction devient de plus en plus importante. Un agent performant doit pouvoir raisonner, mais il doit aussi disposer d'un environnement dans lequel accomplir réellement les tâches demandées. C'est précisément à cette frontière entre calcul des modèles et exécution des outils que NVIDIA souhaite développer sa présence. Vera n'a pas besoin de remplacer tous les GPU ni tous les processeurs existants pour trouver un marché. Il lui suffit de démontrer un avantage suffisamment important dans certaines charges à forte valeur économique. Les premiers essais de Modal suggèrent que l'exécution simultanée de nombreuses Sandboxes pourrait constituer l'un de ces domaines. Reste à établir si les résultats se maintiendront lorsque davantage de clients utiliseront réellement ces machines.
Le succès de Vera se jouera dans les centres de données, pas dans les démonstrations
Le chiffre de deux fois plus de tâches exécutées attire immédiatement l'attention. Mais la partie la plus intéressante de cette annonce se situe derrière le résultat. Modal affirme que Vera conserve un débit élevé lorsque les serveurs accueillent un grand nombre d'environnements concurrents. Si cette propriété se vérifie à grande échelle, elle pourrait permettre de mieux utiliser chaque machine et de limiter certains goulets d'étranglement dans les applications d'IA agentique. Pour les développeurs, le bénéfice ne se mesurera pourtant pas uniquement en benchmarks. Il faudra regarder les délais réels, la compatibilité des outils, le coût par tâche et la stabilité du service. Pour NVIDIA, l'enjeu est encore plus large. La société veut démontrer que ses processeurs centraux peuvent devenir aussi stratégiques dans les centres de données d'IA que ses accélérateurs graphiques. Modal constitue un premier exemple intéressant d'adoption par une entreprise historiquement dépendante des architectures concurrentes. Mais la transition vers Arm devra encore être réalisée et les résultats confirmés en production. Une chose apparaît déjà clairement : à mesure que les modèles passent de la génération de réponses à l'exécution de tâches, le CPU redevient un élément central de la performance. La prochaine bataille de l'intelligence artificielle ne concernera donc pas seulement les GPU les plus puissants. Elle portera aussi sur les serveurs capables de faire travailler des milliers d'agents sans que leurs tâches se ralentissent mutuellement.